
Loudness normalization — как алгоритмы платформ решают, чей трек звучит сильнее
Большинство артистов до сих пор конкурируют по LUFS. Они поднимают громкость, уплотняют микс, давят лимитером — и проигрывают сразу после релиза.
Проблема не в цифрах. После загрузки трек сразу попадает в сравнение с другими релизами.
Loudness normalization — это не инструмент выравнивания громкости. Это механизм, который приводит все треки к одной точке и оставляет только разницу в восприятии. Именно эти различия и решают, какой трек звучит сильнее.
Платформа не делает треки равными. Она делает их сравнимыми.
Именно здесь релиз теряет конкурентоспособность. Трек может соответствовать цифрам и при этом проигрывать сразу после загрузки.
Современный мастеринг — это работа не с цифрами, а с поведением трека внутри платформы. Если это не учитывать — трек теряет позицию сразу после загрузки. Подробнее это раскрыто в материалах по мастерингу для стриминговых сервисов и цифровому релизу.
Loudness normalization — это система сравнения, а не выравнивание громкости
 Термин “нормализация” вводит в заблуждение.
Возникает иллюзия, что платформа делает треки одинаковыми по громкости.
В реальности происходит другое: все релизы приводятся к условной отправной точке, после которой начинается сравнение.
Система убирает только крайние отклонения по уровню. Дальше система не вмешивается — и оставляет треки конкурировать в исходном виде. После этого вступает в силу восприятие — то, как трек ощущается, а не какие у него показатели.
Именно здесь цифры перестают иметь значение. Два трека могут иметь одинаковый уровень, но один звучит плотно и уверенно, а другой — плоско и слабо. Разница формируется не в цифрах, а в самом сигнале.
Loudness normalization не корректирует баланс, не восстанавливает динамику и не делает звук “лучше”. Он задает рамку, внутри которой уровень перестает быть фактором.
Поэтому равный LUFS не означает равное восприятие. Алгоритм убирает числовое преимущество, но оставляет разницу в атаке, плотности, транзиентах и спектре. Именно эти параметры решают, какой трек выигрывает в реальном прослушивании.
Ошибка возникает в тот момент, когда мастеринг строится вокруг достижения конкретного уровня. Цифра достигается, но поведение трека внутри платформы не учитывается. В результате релиз формально “правильный”, но проигрывает при прямом сравнении с другими треками.
Чтобы избежать этого, необходимо разделять измерение и восприятие. Метрики фиксируют только уровень, но не отражают поведение сигнала, тогда как итоговое звучание определяется тем, как сигнал проходит через алгоритм и воспринимается слушателем. Разница между цифровыми уровнями и реальным результатом подробно раскрыта на странице LUFS vs dBFS, а ориентиры по звучанию коммерческих релизов разобраны в материале референсных уровней громкости.
Как платформы ранжируют треки после нормализации
Нормализация — это только первый этап обработки. Она убирает разницу в уровне, чтобы треки оказались в одной точке отсчета. Дальше начинается то, что напрямую влияет на восприятие: сравнение самих записей между собой.
После выравнивания уровень перестает быть преимуществом. Платформа оставляет только структуру сигнала — то, как трек “собран” внутри. И именно здесь возникает расслоение: одни релизы звучат собранно и уверенно, другие теряют давление и читаемость.
Первое, что влияет на результат — плотность. Если материал перегружен лимитированием, он становится однородным. Такой трек теряет микродинамику и перестает “двигаться”. В потоке он не получает преимущества, потому что внутри него нет контраста.
Второй фактор — динамика. Речь не о громкости, а о разнице между тихими и громкими участками. Если эта разница уничтожена, трек воспринимается как плоский массив. Платформа не исправляет это — она только фиксирует, что сигнал уже лишен глубины.
Третий уровень — спектр. Баланс частот напрямую влияет на ощущение громкости. Перегруженный низ или агрессивная середина могут визуально “поднимать” трек, но после нормализации это превращается в утомляющее звучание. Такие записи проигрывают при длительном прослушивании рядом с более сбалансированными релизами.
Треки остаются разными даже после выравнивания уровня. Убирается только возможность влиять на результат за счет уровня. Все остальное — плотность, динамика, спектральный баланс — остается и начинает играть решающую роль.
Поэтому два трека, приведенные к одному уровню, не воспринимаются одинаково. Один сохраняет энергию и читаемость, второй звучит слабее, хотя формально соответствует тем же параметрам. Это и есть скрытая стадия ранжирования — не по цифрам, а по восприятию.
Именно здесь решается, будет ли трек удерживать внимание или выпадет из потока. Разница не в уровне, а в том, как трек переживает нормализацию и сохраняет структуру после нее. Подробный разбор причин, по которым трек уступает референсам, разобран на странице почему трек хуже референса, а влияние контроля прослушивания на такие решения раскрыто в материале мониторинг для мастеринга.
Replay Gain — почему алгоритм оценивает не цифры, а ощущение громкости
В основе нормализации лежит не уровень сигнала, а его восприятие. Именно это реализует логика Replay Gain — система, которая анализирует не пики и не максимальные значения, а то, как трек ощущается при прослушивании.
Система проходит по всему материалу и оценивает среднюю воспринимаемую громкость. Она учитывает распределение энергии во времени, реакцию слуха на разные частоты и поведение сигнала в динамике. В результате формируется не просто измерение, а коэффициент, который определяет, насколько трек будет ослаблен при воспроизведении.
Этот коэффициент применяется к аудио как единое изменение gain. При этом платформа не учитывает, как трек был сделан. Для него нет разницы между аккуратным мастерингом и перегруженным сигналом — он оценивает только итоговое восприятие.
Это означает, что работа с уровнем до загрузки не дает преимущества. Трек не перерабатывается и не “улучшается” — его просто опускают до нужного уровня относительно других записей. После этого он попадает в общий поток, где уже сравнивается по восприятию.
Ключевой момент — пики не играют решающей роли. Кратковременные всплески громкости не влияют на итоговую оценку, если основная масса сигнала остается плотной и перегруженной. Это полностью обнуляет логику работы от максимального уровня.
В результате трек, собранный “в потолок”, не получает преимущества. Он просто сильнее ослабляется алгоритмом, потому что его воспринимаемая громкость выше. При этом структура сигнала остается прежней — без динамики и с ограниченным диапазоном.
Именно поэтому подход “сделать громче любой ценой” работает против самого релиза. Система воспринимает такой материал как избыточный и корректирует его сильнее, чем более сбалансированные треки. В итоге разница между ними становится еще заметнее после нормализации.
Система не изменяет трек — она проявляет его слабые и сильные стороны. А записи с сохраненной динамикой и контролируемым балансом остаются читаемыми и устойчивыми в потоке.
Контроль этого поведения невозможен без анализа итогового уровня уже после мастеринга. Как именно проверяется результат перед релизом, разобрано на странице контроля LUFS в Spotify, а влияние интегрального восприятия громкости раскрыто в материале integrated LUFS, где оценивается не момент, а весь трек целиком.
Почему одинаковые по LUFS треки проигрывают друг другу
Одинаковый LUFS создает иллюзию равенства. По цифрам треки находятся на одном уровне, но при воспроизведении один звучит глубже и мощнее, а другой — сжатым и уставшим. Разница формируется внутри сигнала, а не в его измерении.
Первый фактор — crest factor. Это соотношение между пиками и средним уровнем. Когда оно сохраняется, трек дышит: атаки пробиваются, удары читаются, пространство остается живым. При агрессивном лимитировании это соотношение разрушается — пики прижимаются к среднему уровню, и сигнал теряет контраст.
В результате два трека с одинаковым LUFS ведут себя по-разному. Один сохраняет амплитуду движения, другой превращается в ровный массив без выраженных акцентов. После нормализации это различие становится еще заметнее.
Второй элемент — транзиенты. Короткие атаки формируют ощущение энергии и “удара”. Если они сглажены или срезаны, трек теряет читаемость, особенно на фоне других записей. Алгоритм не восстанавливает транзиенты — он фиксирует их текущее состояние.
Третий уровень — плотность. Перегруженный сигнал может казаться громким при работе в студии, но в сравнении он быстро утомляет. Избыточная плотность убирает глубину и делает звук плоским. Такие треки проигрывают даже при равных показателях, потому что не удерживают внимание.
Именно поэтому громкий трек может звучать слабее. Он теряет внутреннюю структуру, которая формирует ощущение силы. После выравнивания уровня цифры перестают играть роль, а различия в динамике и атаках остаются — и начинают определять итоговое восприятие.
Попытки компенсировать это дополнительной громкостью приводят к обратному эффекту. Чем сильнее сжат сигнал, тем меньше у него остается инструментов для конкуренции внутри платформы. Разбор того, почему увеличение уровня не решает проблему, раскрыт на странице как сделать трек громче, а различия между лимитированием и клиппингом подробно рассмотрены в материале лимитер или клиппер, где видно, как разные подходы влияют на структуру сигнала.
Таблица — как normalization ведет себя на разных платформах
Алгоритмы нормализации не идентичны. Они используют схожую логику выравнивания, но по-разному обрабатывают материал после приведения к baseline. Именно эти различия влияют на то, как трек воспринимается в разных сервисах.
| Платформа | Baseline | Поведение алгоритма | Риск для трека |
|---|---|---|---|
| Spotify | Единая точка сравнения для всего каталога | Анализирует воспринимаемую громкость и приводит трек к общему уровню, после чего оставляет разницу в динамике и плотности | Пережатые треки теряют энергию и звучат слабее в плейлистах |
| YouTube | Выравнивание относительно видео-контента | Сохраняет различия в спектре и атаке, при этом сглаживает избыточную громкость | Агрессивная середина и перегруженный низ делают звук утомляющим |
| Apple Music | Контроль громкости в рамках всей библиотеки | Более мягко обращается с динамикой, но фиксирует различия в структуре сигнала | Плоские треки звучат менее объемно на фоне динамичных релизов |
| TikTok | Быстрое выравнивание под короткий формат | Ориентируется на мгновенное восприятие и плотность первых секунд | Слабые транзиенты и размытая атака делают трек незаметным |
Разница между платформами не в цифрах, а в том, как они интерпретируют сигнал после нормализации. Один и тот же мастер может вести себя по-разному в зависимости от среды воспроизведения. Особенности подготовки под каждую площадку разобраны отдельно: мастеринг для Spotify, мастеринг для YouTube, мастеринг для Apple Music и мастеринг для TikTok, где учитывается не только уровень, но и поведение трека после загрузки.
Ты не контролируешь алгоритм — значит проигрываешь релиз
Нормализация убирает разницу в уровне, но не делает треки равными. Если мастеринг не учитывает поведение платформ — трек теряет позицию сразу после загрузки. Отправьте материал и получите бесплатный демо-мастеринг (до 30 секунд), адаптированный под реальные механики стриминга.
Отвечаем в течение 1–2 часов. Работаем онлайн по всей России.
Главная ошибка — мастеринг под цифры вместо поведения алгоритма
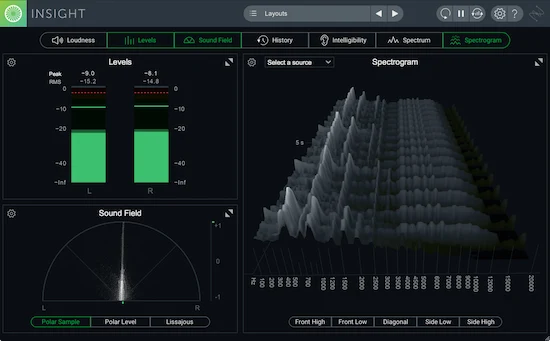 Большинство релизов до сих пор строится вокруг целевого уровня.
Выбирается цифра, под нее подгоняется сигнал, после чего трек считается “готовым”.
Проблема в том, что платформа не оценивает результат по этим значениям.
LUFS используется как ориентир, но не как критерий качества. Платформа берет трек, приводит его к общей точке и дальше игнорирует сам факт достижения этого уровня. Остается только то, как сигнал воспринимается после нормализации.
В этот момент вся логика “попасть в нужную цифру” перестает работать. Трек может идеально соответствовать выбранному значению, но при этом звучать слабее рядом с другими релизами. Причина — в несоответствии структуры сигнала поведению алгоритма.
Когда мастеринг строится под цифры, теряется контроль над тем, что происходит после загрузки. Избыточное лимитирование, выравнивание динамики и попытка удержать постоянную плотность приводят к тому, что трек становится предсказуемым и статичным. Алгоритм ничего не исправляет. Он усиливает разницу между сильными и слабыми треками.
В результате цифра достигнута, а конкурентоспособность потеряна. После нормализации такой материал лишается даже того преимущества, ради которого он был сжат. Он становится ровным по уровню, но пустым по ощущению.
Главный миф — считать, что нормализация делает треки одинаковыми. На практике она только убирает возможность выиграть за счет уровня, но усиливает различия в качестве сигнала.
Цифры не описывают результат. Они показывают, что происходит до загрузки, но не отражают поведение трека внутри платформы. Разница между этими двумя состояниями и определяет итоговое восприятие.
Именно поэтому попытка “попасть в нужный уровень” не гарантирует ничего. Платформа не сравнивает значения — она сравнивает звучание после выравнивания. И если структура сигнала не выдерживает этого сравнения, никакая цифра не спасает релиз.
Понимание того, какой уровень действительно нужен до мастеринга, разобрано на странице какая громкость нужна для мастеринга, а вопрос построения обработки без привязки к шаблонным значениям раскрыт в материале цепочка мастеринга, где акцент делается не на цифрах, а на поведении сигнала.
Как мастеринг влияет на результат после normalization
После загрузки трек перестает контролироваться в том виде, в котором он был утвержден. Алгоритм меняет его положение по уровню и помещает в поток других релизов. В этот момент становится видно, насколько мастеринг был готов к такому сценарию.
Если мастеринг строился вокруг громкости — результат разваливается сразу после загрузки. Если же сигнал изначально собран с учетом поведения платформ, он сохраняет читаемость и энергию даже после нормализации.
Первый уровень — контроль динамики. Речь не о том, чтобы сделать трек “громче” или “тише”, а о том, как внутри него распределяется энергия. Когда динамика уничтожена, сигнал превращается в равномерную массу. После выравнивания такой трек теряет глубину и перестает удерживать внимание.
Сохраненная динамика работает иначе. Атаки остаются выразительными, паузы не исчезают, контраст между участками сохраняется. Даже после снижения уровня трек продолжает двигаться и воспринимается как более мощный.
Второй компонент — баланс спектра. Алгоритмы чувствительны к распределению частот. Перегруженный низ или агрессивная середина могут создавать иллюзию силы до загрузки, но в потоке такие треки звучат утомляюще и теряют читаемость.
Сбалансированный спектр ведет себя иначе. Он не давит и не разваливается при снижении уровня. Трек остается прозрачным, а его элементы не конфликтуют друг с другом даже после нормализации.
Третий аспект — адаптация под алгоритм. Мастеринг перестает быть финальной стадией и становится подготовкой к алгоритмам платформ. Это означает контроль не только исходного звучания, но и того, что произойдет после применения gain.
Именно здесь проходит граница между технически корректным и конкурентоспособным релизом. Первый соответствует параметрам, второй выдерживает сравнение внутри платформы. Разница формируется не на этапе измерения, а в том, как сигнал переживает нормализацию.
Мастеринг в этом контексте — это не доведение до нужного уровня. Это настройка поведения трека в системе, где уровень уже не является преимуществом. И если этот фактор игнорируется, релиз теряет позицию сразу после публикации.
Подход, при котором обработка ориентирована на итоговое восприятие, раскрыт на странице профессионального мастеринга трека, а влияние таких решений на результат релиза разобрано в материале мастеринга для музыкантов, где учитывается не только звук до загрузки, но и его поведение внутри платформ.
Loudness normalization в России — почему большинство треков теряет конкурентоспособность
Основная проблема — попытка выиграть громкостью там, где громкость не работает. Треки перегружаются еще до загрузки на платформы, после чего теряют структуру, за счет которой могли бы конкурировать в стриминге.
Логика остается прежней: чем громче — тем лучше. Но после загрузки это преимущество исчезает. Алгоритм снижает уровень и оставляет сигнал в том состоянии, в котором он был собран. Если динамика разрушена, а спектр перегружен, трек не выдерживает сравнения с более сбалансированными релизами.
В результате возникает парадокс. Материал, который казался “сильным” в студии, в потоке звучит слабее и менее выразительно. Причина не в качестве записи, а в том, что мастеринг не учитывает поведение normalization.
Вторая проблема — непонимание того, как работает нормализация. Нормализация воспринимается как ограничение по уровню, а не как система сравнения. Из-за этого вся работа строится вокруг достижения цифры, а не вокруг того, как трек будет звучать после обработки платформой.
Такой подход приводит к одинаковому результату: пережатые треки теряют глубину, атаки сглаживаются, а плотность превращается в утомляющий фон. В итоге они попадают в одинаковые условия воспроизведения с другими релизами, но уже без тех элементов, которые могли бы дать преимущество.
Пока акцент остается на уровне, результат не меняется. Треки соответствуют техническим параметрам, но уступают по восприятию. И именно это различие определяет, будет ли трек звучать конкурентоспособно или потеряется среди других записей.
В итоге конкуренция происходит не между треками, а между ошибками их подготовки. И выигрывает не самый громкий, а тот, чей трек изначально подготовлен под работу платформ.
Алгоритм решает, как будет звучать твой трек
После загрузки контроль над результатом переходит к платформе. Платформа выравнивает громкость и оставляет только то, что действительно влияет на восприятие. Если мастеринг не учитывает это — трек проигрывает сразу. Отправьте материал и получите бесплатный демо-мастеринг (до 30 секунд), адаптированный под реальные алгоритмы стриминговых сервисов.
Отвечаем в течение 1–2 часов. Работаем онлайн по всей России.
FAQ
Нормализация делает трек хуже?
Сама по себе — нет. Алгоритм не “портит” звук и не вмешивается в структуру сигнала.
Он меняет только уровень воспроизведения.
Проблема появляется, когда трек изначально собран с разрушенной динамикой и перегруженным балансом.
После нормализации такие записи теряют остатки энергии и звучат слабее на фоне других релизов.
Стоит ли делать тише под платформы?
Снижение уровня ради цифры не дает преимущества.
Платформа все равно приведет трек к своей точке отсчета.
Если сигнал собран правильно, он сохранит читаемость после нормализации вне зависимости от исходного уровня.
Если нет — станет еще менее выразительным.
Одинаковый LUFS — это одинаковый результат?
Нет.
LUFS фиксирует уровень, но не описывает структуру сигнала.
Два трека с одинаковыми значениями могут отличаться по плотности, атаке и динамике.
После нормализации эти различия остаются и определяют, какой трек звучит сильнее.
Normalization работает одинаково на всех платформах?
Принцип схожий — приведение треков к общей точке сравнения.
Но поведение алгоритмов отличается.
Разные сервисы по-разному реагируют на плотность, спектр и динамику.
Поэтому один и тот же мастер может звучать по-разному в зависимости от площадки.
Можно ли обойти алгоритмы нормализации?
Обойти — нет.
Алгоритм применяется ко всем релизам.
Единственный способ получить преимущество — подготовить трек так, чтобы он сохранял энергию и читаемость после выравнивания.
Это не борьба с системой — это работа по ее правилам.